Agentes de código y Android Bench 2.0
Google lanza Android Bench 2.0 con tareas de ingeniería de largo plazo (LHTs). ¿Por qué los modelos que arrasan en LeetCode se quedan en un 28% al refactorizar arquitecturas reales?
Advertisement (top)
Space reserved for AdSense
Agentes de código y la realidad de la ingeniería: El golpe de realidad de Android Bench 2.0
Durante los últimos dos años, los anuncios sobre inteligencia artificial aplicada al desarrollo de software se han medido en una métrica fetiche: la tasa de aciertos en pruebas sintéticas. Vimos modelos romper récords en HumanEval, resolver problemas de tipo LeetCode Hard en segundos y solucionar issues aislados de GitHub en SWE-bench. La narrativa era directa: si la IA puede resolver algoritmos complejos, reemplazar el trabajo de un ingeniero de software es cuestión de tiempo.
Sin embargo, el lanzamiento de Android Bench 2.0: Pushing the frontier with challenging long-horizon tasks por parte del equipo de Android en Google ha arrojado un balde de agua fría sobre esa percepción.
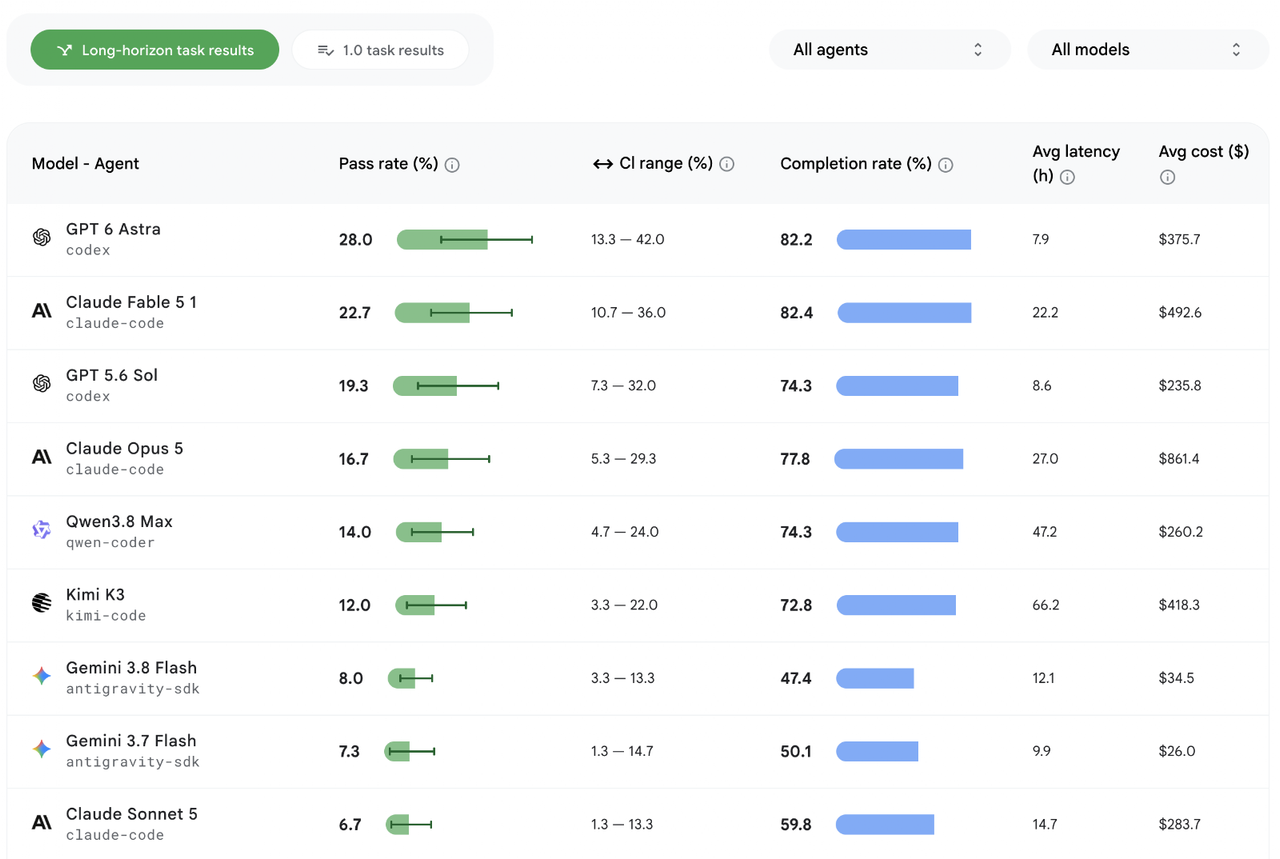
Al enfrentar a los agentes autónomos contra el trabajo cotidiano de ingeniería —migrar proyectos enteros, lidiar con inyección de dependencias rota, actualizar SDKs y convertir apps multiplataforma— la tasa de éxito cayó en picada: apenas un 28% de aprobación para los modelos de frontera más avanzados.
1. El fin del “pass/fail” binario y el auge de las LHTs
Los benchmarks clásicos operaban bajo una simplificación extrema: o el parche de código pasa todos los tests unitarios (pass), o se considera un fallo total (fail). Esa métrica funciona cuando el objetivo es corregir un error tipográfico en una función matemática, pero resulta inútil para medir proyectos de ingeniería reales.
¿Qué son las Long-Horizon Tasks (LHTs)?
En Android Bench 2.0, Google introdujo las LHTs (Tareas de Largo Horizonte): desafíos arquitectónicos que a un desarrollador humano le toman entre varios días y una semana completa de trabajo. Algunos ejemplos evaluados incluyen:
- Refactorizaciones estructurales: Migrar 40 pantallas tradicionales basadas en XML a Jetpack Compose.
- Actualización profunda de dependencias: Reemplazar capas de red completas (por ejemplo, cambiar Retrofit por Ktor) y reconfigurar la serialización.
- Migraciones cross-platform: Convertir aplicaciones móviles multiplataforma hacia arquitectura nativa en Kotlin.
- Integración de persistencia: Diseñar esquemas de base de datos relacional (Room/SQL) manteniendo la coherencia de los modelos de dominio.
La necesidad de un “Continuous Scoring”
Bajo la óptica binaria anterior, si un agente refactorizaba 40 pantallas, creaba los repositorios y cumplía el 95% de los requisitos, pero fallaba en una aserción de un caso límite en la interfaz visual, el resultado se registraba como 0% de éxito.
Android Bench 2.0 reemplaza esto por una puntuación continua compuesta por:
- Funcionalidad comprobada: Ejecución real en dispositivos y emuladores.
- Fidelidad visual: Comparación de layouts y coherencia de diseño.
- Ausencia de regresiones: Que las pantallas modificadas no rompan módulos no relacionados.
- Penalizaciones por desvío: Castigos automáticos si el agente ignora restricciones estructurales o directivas del prompt inicial.
2. Radiografía del 28%: ¿Por qué falla la IA en proyectos reales?
El salto de complejidad expuso una brecha que los benchmarks sintéticos ocultaban de forma sistemática:
┌──────────────────────────────────────┐       ┌──────────────────────────────────────┐
│       Pruebas Aisladas (LeetCode)    │       │     Ingeniería Real (LHTs)           │
├──────────────────────────────────────┤       ├──────────────────────────────────────┤
│ • Estado autocontenido en memoria    │       │ • Efectos secundarios en runtime     │
│ • Entrada y salida predecible        │  VS   │ • Grafos de dependencias rotos (DI)  │
│ • Contexto < 2,000 tokens            │       │ • Millones de tokens acumulados      │
│ • Sin interacciones entre módulos    │       │ • Fricción entre SDKs no declarados  │
└──────────────────────────────────────┘       └──────────────────────────────────────┘
A. La trampa de la validación en tiempo de ejecución (Runtime Failures)
Escribir código sintácticamente válido es sencillo para un LLM. Lo que resulta crítico en Android Bench 2.0 es el ciclo de compilación e inyección de dependencias (por ejemplo, con Dagger/Hilt o Koin). Un agente puede generar clases de servicio impecables, pero si olvida registrar un módulo en el grafo o introduce una dependencia cíclica, la aplicación compila pero colapsa en el arranque con un IllegalStateException.
B. Síntesis vs. Mantenimiento
Los resultados de la comparativa confirmaron un principio fundamental: los modelos son mucho mejores escribiendo código desde cero que refactorizando código existente.
- Al crear código nuevo, el modelo impone sus propios supuestos y patrones.
- Al refactorizar, el agente debe inferir decisiones de diseño tomadas años atrás por otros humanos, respetar jerarquías implícitas y evitar mutar estados compartidos.
C. La pérdida de memoria en cadenas largas de herramientas (Harness Drift)
Para completar una migración de 8,000 líneas a lo largo de 125 archivos, un agente debe ejecutar decenas de comandos de terminal, leer trazas de error de Gradle, inspeccionar archivos y aplicar parches sucesivos. Conforme la conversación supera los cientos de miles de tokens, el agente empieza a olvidar instrucciones iniciales, reintroduce errores ya corregidos o entra en bucles de prueba y error que disparan los costos de inferencia sin avanzar en la tarea.
3. Análisis en Video: Comparando Agentes de Código en Entornos Reales
Para comprender cómo se comportan los entornos de ejecución y los arneses de herramientas (agent harnesses) bajo estrés en proyectos de código complejos, el siguiente análisis práctico desglosa las diferencias entre los agentes más utilizados de la industria:
Análisis comparativo de agentes autónomos de desarrollo (Codex, Claude Code, GLM) en escenarios prácticos de programación.
4. Las fortalezas demostradas: ¿Dónde sí brilla la IA?
A pesar de que el 28% de tasa de aprobación global demuestra que la autonomía total sigue lejana, Android Bench 2.0 no arrojó únicamente malas noticias. Reveló áreas donde los agentes ya exhiben una precisión notable:
- Transformaciones determinísticas a gran escala: Los agentes resolvieron con alta consistencia la conversión de clases legadas de Java a Kotlin, o la sustitución sistemática de llamadas HTTP entre librerías conocidas.
- Repetición con disciplina: Cuando la regla de migración está claramente definida en la especificación, los modelos lograron aplicar el mismo patrón arquitectónico de manera uniforme en repositorios con más de un centenar de archivos.
El cuello de botella no radica en la capacidad de teclear código repetitivo, sino en la toma de decisiones estratégicas ante la ambigüedad.
Conclusión: El desarrollador como arquitecto y árbitro de contexto
Android Bench 2.0 marca el inicio de una etapa más madura en las herramientas de IA para desarrolladores. La métrica del 28% desmonta el mito de que los agentes pueden recibir una especificación vaga de producto y entregar una migración lista para producción sin supervisión.
La verdadera ventaja competitiva para los equipos de ingeniería no será delegar la aplicación completa a un agente ciego, sino utilizar la IA para el trabajo pesado y determinista, reservando el juicio humano para la coherencia arquitectónica, el diseño de contratos y la validación en tiempo de ejecución.
Referencias técnicas
- Android Developers Blog: Android Bench 2.0: Pushing the frontier with challenging long-horizon tasks (Septiembre 2026).
- Developer Tech News: Google’s Android Bench 2.0 tests AI models on complex tasks.
Advertisement (bottom)
Space reserved for AdSense